万博manbext体育官网app官网随着视频生成模子限度扩大-万博manbext体育官网(中国)官方网站登录入口
好家伙,字节这回平直把AI生成玩成盛开天下了?!
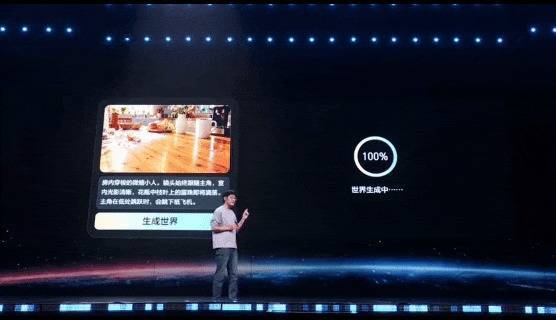
瞧嘛,只需输入一句话,AI就臆造roll出一个微缩常人视角下的房间~
紧接着,键盘鼠标一顿猛如虎操作,咱就能骑上纸飞机在赛博天下里解放航行,想去哪儿就去哪儿:
这还没完,在这个AI生成的天下里,连目前的东西都能唾手创造!
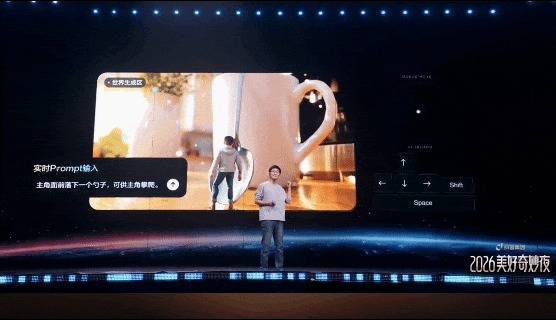
想要个勺子?平直臆造搓一个出来,以致…
咱们还能跟勺子交互,把频频餐具玩成大型攀岩现场——
天然,这个天下能作念的还远不啻这些。
靠着狂放门功能,两个八竿子打不着的场景也能平直连通。
上一秒还在屋里,下一秒排闼就闯进外天际了?!
如斯奇幻的一幕,就出当今刚刚收尾的抖音集团《2026 好意思有趣妙夜》科技节目现场,演示者正是影视飓风的Tim。
更值得一提的是,这一连串号称赛博造物的操作,背后正是字节一直在肃静研发的天下模子。(战栗.jpg)
天然模子目前尚未持重发布,但从现场展示来看,其依然展现出三维场景生成、解放探索、及时交互、物体剪辑,以致不同空间之间的解放连通的技艺~
此次字节借着节目现场演绎,让自家的天下模子来了场出其不虞的「初度亮相」,属实亦然提前秀了一把肌肉了。
提及来蛮感触的,这几年,从李飞飞创办的World Labs,到Google DeepMind的Genie,再到英伟达的Cosmos。
一众科技巨头也纷纷下场,试图让AI进一步瓦解空间结构、模拟推行规章,以致展望环境奈何随东说念主的步履而变化。
如今,AI正在把科幻电影里的天下搓进推行。
从画出一个天下,到让总共这个词天下「活」过来我猜,早些年起首玩AIGC的那批东说念主,就怕也没意料——
有一天AI生成的视频,竟能酿成一个不错走进去、相沿交互、还能纯真剪辑的赛博三维天下。
我略略细数了一下,从岁首启动到当今,我上手体验过的天下模子家具也不祥都有六七个了。。。
其颠簸进度吧,不亚于前一天还在看《星际穿越》,第二天就发现我方能走进银幕,顺遂还能把黑洞搬到自家客厅。
是以,AI咋就能从图视频生成,丝滑「转服」到造天下了啊?!
这事儿,还得从传统多模态生成的一块技巧短板提及。(doge)
如今,天下模子已生息出多条技巧阶梯,从详细状态展望、物理因果建模,到生成式三维天下,各有侧重。
而这里咱们要聊的,主如果与多模态生成、空间智能联系的一条阶梯:
让AI学习推行天下的空间结构与变化规章,进而生成、重建和模拟一个能够连续探索、及时交互的三维天下。
需要敲黑板的是,这里有两个瑕疵词:空间结构以及变化规章。
而这两项智商,恰恰切中了往时几年视觉生成技巧尚未全都责罚的一说念基础性艰辛。
△AI生成
2024年,OpenAI发布Sora,惊艳的生成视频平直让全网随着山姆·奥特曼战栗昏迷瘫坐。
但比起当年那些刷屏的视频,OpenAI同期发布的技巧阐明,放到今天反而更值得细品——
《Video generation models as world simulators》,直译过来即是「四肢天下模拟器的视频生成模子」。
彼时OpenAI发现,随着视频生成模子限度扩大,模子启动涌现一定的三维一致性、物体持久性,以致能够模拟简短的环境交互。
但烦嚣的是,一个能够生成传神天下画面的模子,仍然可能连最基本的「物理关系」都处理不好。
比如Sora能够生成一个东说念主在跑步机上驰驱的画面,东说念主物、光影、镜头都像那么回事儿。
但仔细一看,东说念主物动作与跑步机的通达关系,却偶然稳妥推行中的物理逻辑,画面很简直,物理规章却有点随缘??
△图源:OpenAI官网
这背后,其实露馅了传统视觉生成技巧一个十分根蒂的问题。
往时几年,不管扩散模子照旧基于Transformer的生成架构,主流图像、视频模子主要依靠学习海量视觉数据中的统计规章,来生成稳妥输入条款的画面。
这套门径十分告成了,以致依然能够隐式学习部分三维几何、物体关系和物理规章。
但视觉上的时空一语气性,并无谓然对应一套踏实、可供外部动作打扰的天下状态——
举个例子,让一个杯子在视频中长久保持外不雅一致,对如今的生成模子来说,依然相对容易。
但当它被提起、放下以致推落桌边时,模子还需要连续跟踪空间位置、物体关系与状态变化,并展望碰撞、陨落等物理终结。
换句话说,从生成一段稳妥物理直观的视频,到可靠展望动作激励的环境变化,中间还隔着一个天下状态建模问题。
而这,恰正是天下模子擅长的所在。
本年6月,李飞飞团队发布了一篇名为《A Functional Taxonomy of World Models》的著述。
著述从功能角度将天下模子差别为三种类型,也让天下模子究竟有哪些「真技艺」,有了更明晰的解说——
渲染器:负责天下看起来是什么样式,输露面向东说念主类的视觉画面,中枢办法是画面简直度、视觉阐扬力。模拟器:负责天下骨子上是什么样式,爱戴稳妥几何、物理因果的场景状态。运筹帷幄器:负责智能体下一步该奈何步履,基于现时天下状态与既定办法,输出合理动作。这套差别值得玩味的所在在于,它恰恰解说了为啥AI已能生成以伪乱真的视频,咱们却还要费这样大劲去议论天下模子。
从生成传神的视觉画面,到督察稳妥物理规章的环境状态,再到相沿智能体自主决策与步履——
其背后波及的空间表征、动态展望与步履运筹帷幄智商,恰正是传统多模态生成模子尚未充分责罚的技巧艰辛。
而如今,论文里这些看起来颇为牛年马月的天下模子构想,依然启动被AI极少点「搓」出来了。
△图源:《A Functional Taxonomy of World Models》著述
就拿抖音集团《2026 好意思有趣妙夜》科技节目上,基于字节AI模子实现的那番赛博造物操四肢例。
单凭一句话生成画面,放到今天早已算不上什么有数事儿。
可当东说念主真的走进这片AI生成的场景能够解放穿行时,此时模子需要处理的依然从生成目前这一幅画面,延长到了督察总共这个词场景的空间结构。
不管东说念主往哪个标的移动、从哪个角度不雅察,场景中的地形、物体尽头相对位置,都需要保持实足的几何一致性。
这背后体现的,正是天下模子的空间表征智商,亦然让一个AI生成的场景信得过经得起反复探索的基础。
想要一把勺子,AI就能臆造生成,以致还能顺着勺子爬行,实推行时动作交互。
看似简短的几步操作,背后却波及天下模子的即时生成、环境状态建模与动态展望智商——
模子需要证据用户的操作,及时更新场景中的物体及空间关系,并连续展望动作激励的环境变化,保持前后状态的一致性。
以致,连空间自身都能唾手矫正,画出一扇「狂放门」,就能平直把推行房间和外天际一语气起来。
到了这一步,天下模子的智商又上前延长了一层——三维场景重建、空间可控剪辑与跨场景一语气性建模。
模子能够在保留原有场景空间结构的同期,动态重组不同场景的几何沟通,相沿跨场景的一语气探索与及时交互:
从督察空间结构,到响应及时交互,再到相沿场景剪辑与跨空间重组,字节AI模子智商共同指向的亦然天下模子的中枢特征——
AI生成的不再仅仅内容,其生成的是一个能够连续存在、连续变化、连续交互的数字天下。
往时几年,诳言语模子抵制拓展AI处理话语与学问的智商,多模态模子则把生成智商延长到图像、声息和视频。
而如今,随着天下模子的发展,AI启动进一步探索空间结构、环境状态尽头演化规章。
生成式AI的技巧发展,也正从画面有多传神,走向生成的环境能否连续存在、响应交互,以致模拟简直天下的运行。
天下模子,让AI在虚拟天下炼就「真技艺」天然,如果天下模子只可让东说念主类在赛博天下里四处探索,那几许有点大材小用了。
放到更大的产业坐标里看,它还有一层更具遐想力的价值——
让机器在虚拟天下里大限度试验、反复试错,再将习得的智商移动到推行。
毕竟,机器东说念主、自动驾驶等物理AI的发展,经久受制于简直数据网罗本钱高、试错周期长,以及危机、极点场景难以复现等推行为止。
而天下模子提供了一条新旅途:将推行环境转动为可生成、可限制、可反复考据的虚拟试验场。
从生成稀缺试验数据,到模拟复杂环境、考据步履计谋,部分蓝本依赖简直环境的试验设施,有望移动到虚拟天下完成。
这也让天下模子启动从内容生成,进一步延长到物理AI的试验与考据设施,成为机器东说念主、自动驾驶等规模的迫切技巧探索标的。
△AI生成
先来聊聊「试验数据」这事儿。
关于自动驾驶这类物理AI系统来说,越是瑕疵的极点场景,试验数据常常越稀缺。
比如突发事故、极点天气等低频高风险场景,可能跑上多数里程也碰不到几次,而天下模子恰恰能按需生成、反复模拟这些场景。
在抖音集团《2026 好意思有趣妙夜》科技节目现场,他们就展示了这样一个自动驾驶Demo——
救护车倏得驶来、行东说念主横穿马路、交警现场指引。
多样复杂路况被搬进AI生成的虚拟说念路,车辆不错在其中模拟行驶、支吾突发气象,还能通过多机位回放分析驾驶阐扬。
往时依赖多数简直路测才气蕴蓄的长尾场景,如今有望通过天下模子批量生成,并用于自动驾驶系统的反复试验与考据。
除了试验数据,天下模子的产业价值还体当今另一个瑕疵方面——普及物理AI的试验与考据效果。
寰球都知说念,简直机器东说念主每次试验都得实践动作、恭候反馈,失败后还可能需要东说念主工复位、承担硬件损坏的风险。
但这事儿到了三维天下,蓝本挥霍多数时代的试错历程,就有契机酿成可叠加、可并行的模拟实验。
此次抖音集团《2026 好意思有趣妙夜》科技节目现场的家务机器东说念主演示,就反应出了访佛的念念路。
在AI生成的虚拟家庭环境中,机器东说念主不错熟谙持取、搬运、摆放物品等家务操作,还能濒临抵制变化的物体位置、空间布局,更始动作计谋,尝试完成任务。
即便操作失败,也能在虚拟环境中快速复现问题、更始计谋,反复试验和考据。
比较推行中一次次操作、东说念主工复位,天下模子让机器东说念主有契机在不同场景下并行试错,以更低的本钱、更快的速率炼就支吾推行环境的技艺~
放眼总共这个词行业,科技巨头们其实依然沿着不同标的,启动探索天下模子的产业落地了。
本年3月,英伟达将Cosmos天下模子与Isaac仿真平台邻接,让机器东说念主在虚拟环境中生成数据、反复试验。
而这套工业仿真有运筹帷幄,有望大幅镌汰机器东说念主从试验到骨子部署的本钱。
△图源:英伟达官网
更值得一提的是,这股激越以致把上游芯片巨头也卷进来了。
就在刚刚往时的9月,AMD文告豪掷82亿好意思元收购李飞飞的World Labs,意在提前布局天下模子算力需求,为下一代芯片研发铺路。
从机器东说念主虚拟练功,到工业仿真,再到芯片巨头亲自下场。
天下模子的产业竞争,正在沿着产业链一都延长,从模子智商、骨子诓骗,冷静深入到底层算力架构。
天下模子全球竞速,中国玩家的技巧蕴蓄启动已毕天下模子火是真火,但激越背后,一个蛮成心念念的产业称心也冷静浮现。
海表里厂商都在探索奈何构建空间踏实、能够及时交互的三维天下,但各家的技巧蕴蓄、研发要点与诓骗旅途,却有着不小各异——
技巧办法冷静汇合,实现旅途却各有各的门说念。
以国际为例,Google DeepMind的Genie、李飞飞的World Labs,都在探索通用天下模拟智商,重点波及空间结构、环境动态建模与交互式场景生成。
英伟达Cosmos则更迫临物理AI的骨子需求,将天下模子与机器东说念主仿真、合成数据生成邻接,尝试买通虚拟试验与推行诓骗。
几条阶梯各有侧重,但最终都指向一个办法:让AI生成的虚拟环境,冷静具备模拟推行天下的智商。
咱再把视力转向国内。
一个值得祥和的上风是,相较于国际偏重通用天下模拟的探索旅途,国内厂商往时几年在图像、视频生陋习模蕴蓄的技巧智商,为天下模子提供了另一条颇具竞争力的演进旅途。
本年7月Seedance 2.5将单次视频生成时长推广到30秒,还强化了多模态参考限制、镜头通达和一语气叙事智商。
同期发布的图片生成模子Seedream 5.0 Pro,则进一步强化了空间位置瓦解、结构一致性和交互式精确剪辑。
用户在画面上圈出一个位置,以致唾手画几笔,就能让模子针对指定区域进行修改,真·画哪儿改哪儿。
从空间结构的一致性,到万古序的动态一语气性,再到对外部操作的精确响应,恰恰都是构建可交互三维天下绕不开的技巧问题。
往时几年国内厂商在视觉生成和可控剪辑上蕴蓄的技巧,如今也启动流深化向通用天下模子延长的后劲。
1895年,卢米埃尔昆季将一列驶入车站的火车搬上银幕。
彼时的东说念主们不祥很难意料,这项新发明将在尔后的一百多年里,透彻改变东说念主类记载和呈现天下的方式。
一个多世纪后,随着蓄意机图形学、虚拟推行技巧接踵出现,东说念主类启动尝试从不雅看屏幕里的天下,走向千里浸式体验与探索数字天下。
如今,天下模子的出现,又让这段延续百余年的技巧演进,有了新的转变——
机器启动学习推行天下的空间结构与运行规章,尝试生成能够连续探索、及时交互,以致用于模拟推行的虚拟环境。
一百多年前,东说念主类学会了用影像记载天下。
一百多年后,咱们启动尝试让影像成为一个不错躬行投入、以致改变推行的天下。
一百多年往时万博manbext体育官网app官网,此次,咱们终于启动尝试走进我方创造的影像。